
Apache Kafka là một nền tảng xử lý luồng dữ liệu phân tán, mã nguồn mở, được phát triển bởi Apache Software Foundation. Nó nổi tiếng với khả năng xử lý lượng lớn dữ liệu thời gian thực một cách đáng tin cậy và hiệu quả. Kafka hoạt động như một hệ thống nhắn tin công khai - đăng ký (pub - sub), cho phép các ứng dụng khác nhau giao tiếp với nhau thông qua các luồng dữ liệu (stream).
Trong bài viết dưới đây, hãy cùng Z.com tìm hiểu về Apache Kafka nhé!
Tặng miễn phí bộ Plugin 359$ giúp khách hàng tối ưu SEO website
Kafka là gì?
Kafka được phát triển bởi LinkedIn vào năm 2011 để xử lý feed dữ liệu thời gian thực (ước tính hơn 1 triệu tin nhắn mỗi giây hoặc hàng nghìn tỷ tin nhắn mỗi ngày). Kafka được xem là một công cụ xử lý dữ liệu tối quan trọng đối với bất kỳ doanh nghiệp hiện đại nào hiện nay.
Bởi trong bối cảnh dữ liệu ngày càng "phình to", chúng ta cần những công cụ có thể đảm đương được những lượng dữ liệu khổng lồ. Lúc này có hai thách thức được đặt ra: đầu tiên là làm sao để thu thập dữ liệu đó, và thứ hai là làm sao để phân tích dữ liệu thu thập được. Giải pháp là một hệ thống nhắn tin.
Một hệ thống nhắn tin giúp truyền tải dữ liệu giữa các ứng dụng. Nó giúp các ứng dụng tập trung vào dữ liệu, và hệ thống nhắn tin quyết định dữ liệu được chia sẻ ra sao.
Hãy nhìn vào đường truyền dữ liệu trong hình dưới. Chúng ta có hệ thống nguồn (source) và hệ thống mục tiêu (target), và dữ liệu sẽ được trao đổi giữa hai hệ thống với nhau. Trông khá đơn giản phải không?
Hệ thống nguồn có thể là bất kỳ hệ thống nào, ví dụ như một ứng dụng, email, dữ liệu tài chính, dữ liệu stream... Hệ thống mục tiêu cũng có thể là bất kỳ hệ thống nào, như một cơ sở dữ liệu, email, hay phân tích...
Điều gì diễn ra nếu chúng ta có nhiều hệ thống nguồn và mục tiêu, và chúng đồng thời trao đổi dữ liệu với nhau?
Để trao đổi dữ liệu, mỗi hệ thống nguồn phải kết nối với hệ thống mục tiêu, dẫn đến nhiều đường liên kết được thiết lập giữa nhiều hệ thống nguồn và mục tiêu. Mỗi liên kết diễn ra ở nhiều cấp độ, tùy thuộc vào: 1) cách di chuyển dữ liệu, 2) cách định dạng dữ liệu, 3) mô hình dữ liệu, 4) tải lượng dữ liệu gia tăng mỗi lần thiết lập kết nối.
Lúc này mọi rắc rối mới bắt đầu. Và đó là lúc chúng ta dùng đến Kafka.
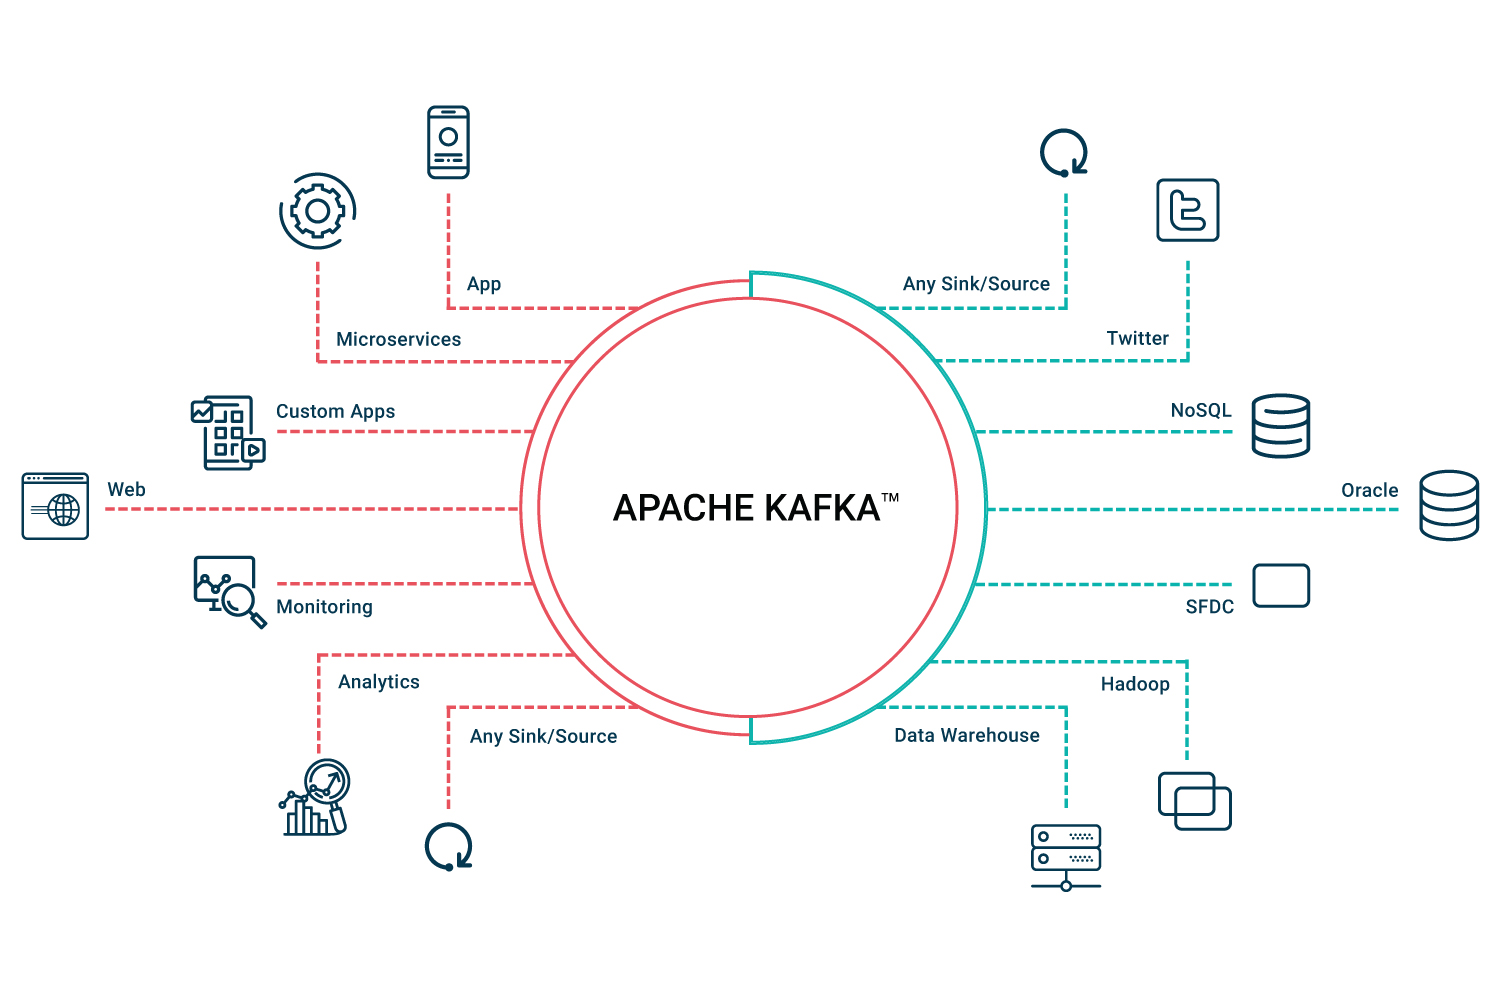
Apache Kafka giúp chúng ta giảm thiểu sự rắc rối giữa các hệ thống nguồn và mục tiêu. Các hệ thống nguồn được gọi là producer, có thể gửi nhiều luồng dữ liệu đến các broker Kafka. Các hệ thống mục tiêu được gọi là consumer, có thể đọc dữ liệu từ nhiều broker và xử lý nó.
Nhiều consumer có thể cùng đọc một luồng dữ liệu chứ không bị giới hạn ở mục đích đơn nhất. Các hệ thống nguồn và mục tiêu hoàn toàn được tách biệt, tránh được việc phải thiết lập các kết nối phức tạp.
Có 2 loại hệ thống nhắn tin mà các công ty có thể sử dụng: point-to-point và publish-subscribe (pub-sub). Trong hệ thống point-to-point, producer sắp xếp dữ liệu theo một hàng đợi và chỉ một ứng dụng có thể đọc dữ liệu từ hàng đợi đó. Tin nhắn chứa dữ liệu sẽ bị loại bỏ khỏi hàng đợi khi hệ thống đọc xong dữ liệu.
Trong hệ thống sub-pub, consumer có thể tiếp cận nhiều chủ đề trong hàng đợi và nhận tin nhắn liên quan đến ứng dụng đó. Kafka được xây dựng dựa trên hệ thống sub-pub này.

Kafka hoạt động ra sao?
Apache Kafka hoạt động dựa trên một cơ chế phân tán mạnh mẽ, cho phép xử lý lượng lớn dữ liệu thời gian thực một cách hiệu quả.
Các thành phần chính của Kafka và cách chúng tương tác
- Producer: Các ứng dụng tạo ra dữ liệu, đóng vai trò như "nhà sản xuất", gửi dữ liệu đến Kafka dưới dạng các bản ghi (record). Mỗi bản ghi được gắn nhãn bằng một khóa (key) và chứa giá trị dữ liệu (value).
- Topic: Dữ liệu trong Kafka được tổ chức thành các chủ đề (topic). Mỗi topic là một luồng dữ liệu logic, tương tự như một thư mục chứa các tệp. Producer gửi bản ghi vào các topic cụ thể, và người tiêu dùng đăng ký vào các topic để nhận dữ liệu liên quan.
- Broker: Kafka chạy trên một cụm gồm nhiều máy chủ gọi là broker. Mỗi broker chịu trách nhiệm lưu trữ một phần dữ liệu và xử lý các yêu cầu đọc/ghi từ producer và consumer. Các broker làm việc cùng nhau để đảm bảo tính khả dụng và độ tin cậy cao.
- Partition: Mỗi topic được chia thành nhiều phân vùng (partition) để tăng khả năng mở rộng. Các bản ghi được phân phối đều trên các phân vùng. Mỗi phân vùng được sao chép trên nhiều broker để đảm bảo tính chịu lỗi.
- Consumer: Các ứng dụng đọc dữ liệu, đóng vai trò như "người tiêu dùng", đăng ký vào các topic và nhận các bản ghi từ các phân vùng. Consumer theo dõi vị trí đã đọc của mình trong mỗi phân vùng để đảm bảo không bỏ lỡ dữ liệu.
- Consumer Group: Nhiều consumer có thể cùng nhau tạo thành một nhóm người tiêu dùng (consumer group) để cùng xử lý dữ liệu từ một topic. Mỗi bản ghi chỉ được gửi đến một consumer trong nhóm, giúp tăng tốc độ xử lý.
Cơ chế hoạt động của Kafka
Producer gửi bản ghi đến broker leader của phân vùng tương ứng.
Broker leader ghi bản ghi vào phân vùng và sao chép đến các broker follower.
Consumer đọc bản ghi từ phân vùng, bắt đầu từ offset (vị trí) đã lưu trước đó.
Consumer gửi xác nhận (acknowledgement) khi đã xử lý xong bản ghi.
Broker leader cập nhật offset của consumer group.
Ứng dụng của Kafka trong các lĩnh vực
Apache Kafka đã và đang chứng minh được tính linh hoạt và hiệu quả của mình trong nhiều ngành công nghiệp khác nhau, giúp giải quyết các thách thức về xử lý dữ liệu thời gian thực và xây dựng các ứng dụng thông minh:
- Tài chính: Kafka được sử dụng để phát hiện gian lận trong giao dịch, phân tích rủi ro tín dụng, xử lý giao dịch chứng khoán tốc độ cao, và xây dựng các nền tảng giao dịch thuật toán. Nó giúp các tổ chức tài chính đưa ra quyết định nhanh chóng và chính xác dựa trên dữ liệu thời gian thực.
- Thương mại điện tử: Kafka hỗ trợ xử lý các luồng sự kiện như hành vi người dùng, thông tin đơn hàng, và dữ liệu sản phẩm, giúp cá nhân hóa trải nghiệm mua sắm, quản lý hàng tồn kho hiệu quả, và tối ưu hóa các chiến dịch tiếp thị.
- Y tế: Kafka được sử dụng để thu thập và phân tích dữ liệu từ các thiết bị y tế, hồ sơ bệnh án điện tử, và các nguồn dữ liệu khác, hỗ trợ chẩn đoán bệnh, theo dõi sức khỏe bệnh nhân, và nghiên cứu y khoa.
- Viễn thông: Kafka giúp các nhà mạng viễn thông xử lý dữ liệu cuộc gọi, tin nhắn, và dữ liệu mạng, cho phép họ giám sát hiệu suất mạng, phát hiện các vấn đề kỹ thuật, và tối ưu hóa chất lượng dịch vụ.
- Vận tải và logistics: Kafka hỗ trợ theo dõi vị trí xe, quản lý chuỗi cung ứng, và tối ưu hóa lộ trình vận chuyển, giúp giảm chi phí và tăng hiệu quả hoạt động.
- Giải trí: Kafka được sử dụng để phân tích dữ liệu người dùng, cá nhân hóa đề xuất nội dung, và xây dựng các nền tảng phát trực tuyến video và âm nhạc.
- Năng lượng: Kafka giúp giám sát và điều khiển các hệ thống điện thông minh, phân tích dữ liệu tiêu thụ năng lượng, và tối ưu hóa việc sản xuất và phân phối điện.
Với khả năng mở rộng, độ tin cậy, và hiệu suất cao, Apache Kafka đang ngày càng trở thành một công cụ không thể thiếu trong việc xây dựng các ứng dụng dữ liệu hiện đại và thúc đẩy sự phát triển của nhiều ngành công nghiệp.
Ưu và nhược điểm của Kafka
Apache Kafka mang đến nhiều lợi ích đáng kể cho việc xử lý dữ liệu thời gian thực.
Với khả năng mở rộng linh hoạt, Kafka có thể đáp ứng nhu cầu xử lý lượng dữ liệu khổng lồ và tăng trưởng nhanh chóng. Tính chịu lỗi cao của Kafka giúp đảm bảo tính liên tục của dịch vụ và giảm thiểu rủi ro mất dữ liệu.
Hơn nữa, Kafka hỗ trợ đa dạng các ứng dụng và tích hợp dễ dàng với nhiều công nghệ khác, mang lại sự linh hoạt và tiện lợi cho người dùng.
Tuy nhiên, Kafka cũng có những hạn chế nhất định. Việc cài đặt và quản lý Kafka có thể phức tạp, đòi hỏi kiến thức chuyên môn và kinh nghiệm.
Hiệu suất của Kafka có thể bị ảnh hưởng bởi cấu hình không tối ưu hoặc việc sử dụng không đúng cách. Ngoài ra, việc đảm bảo an ninh dữ liệu trong Kafka cũng đòi hỏi sự quan tâm và cấu hình cẩn thận.
Tóm lại, Apache Kafka là một công cụ mạnh mẽ và hữu ích cho việc xử lý dữ liệu thời gian thực, nhưng cũng cần được sử dụng một cách cẩn trọng và có hiểu biết để phát huy hết tiềm năng của nó.
Tặng miễn phí bộ Plugin 359$ giúp khách hàng tối ưu SEO website
Bài liên quan
- So sánh chi tiết Wix và WordPress: Đâu là sự lựa chọn tốt nhất?
- Hướng dẫn cài đặt WordPress & những plugin thông dụng nhất
- Kinh nghiệm chống Spam WordPress hiệu quả cao cho người mới
- WordPress Multisite là gì? Hướng dẫn chi tiết cách cài đặt và thiết lập WordPress Multisite
- 7 thủ thuật cải thiện tốc độ website WordPress cho người mới
- Hướng dẫn test tốc độ website chi tiết và dễ thực hiện
- Litespeed là gì? Hướng dẫn tăng tốc website với Litespeed
- Check performance website là gì? Cách check nhanh nhất
- TTFB là gì? Hướng dẫn cải thiện TTFB cho website
- Một số công cụ Test Speed Website bạn không nên bỏ qua
- IP domain check là gì? Cách check nhanh IP của domain/website
- Xoá website
- Ping là gì? Ý nghĩa thông số Ping, cách kiểm tra tốc độ mạng


